Proyectos
Proyectos profesionales
GT Benchmarking
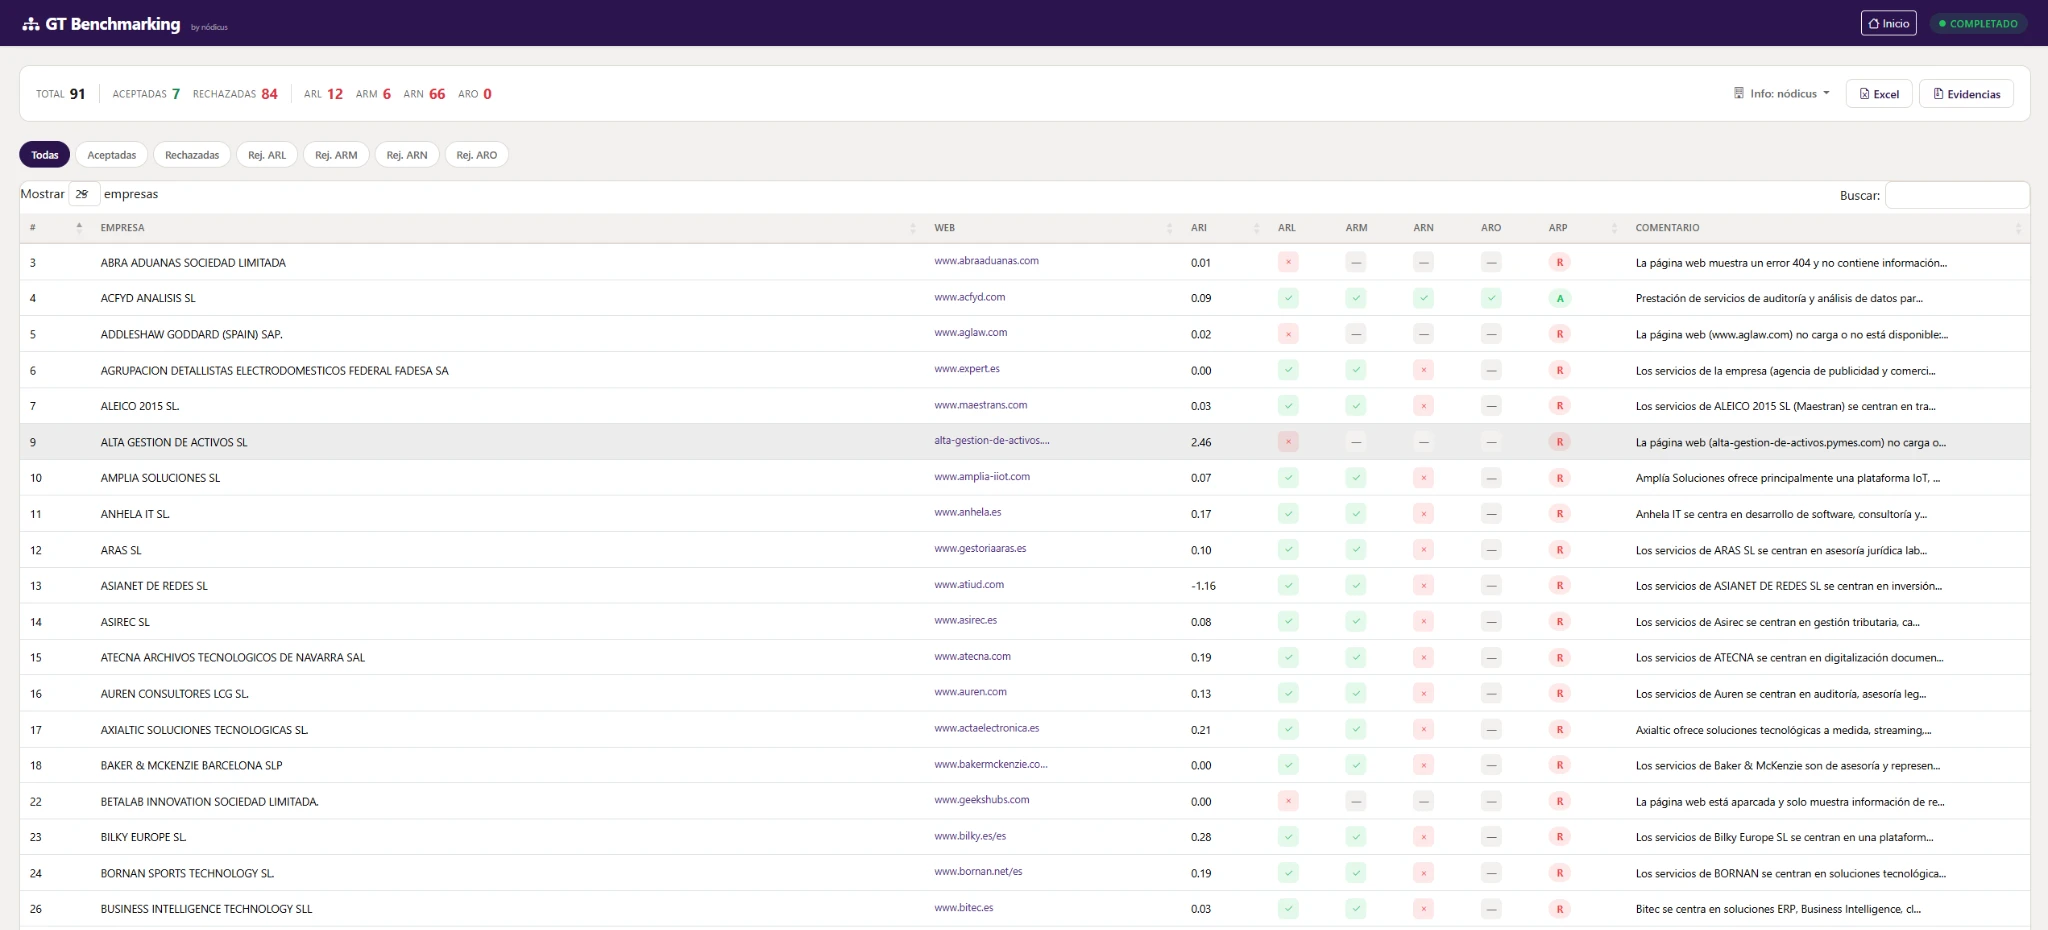
En el LLMthon Legal 2026 cada empresa planteaba un reto, y Pedro (mi socio en nódicus) y yo nos fuimos a por el de Grant Thornton, que consistía en automatizar el benchmarking de precios de transferencia.
Para los que no estéis familiarizados con el tema, cuando una empresa le vende algo a otra de su mismo grupo, Hacienda quiere comprobar que el precio es de mercado. Para demostrarlo se buscan empresas comparables, y aquí es donde está el trabajo pesado. Alguien tiene que entrar en la web de cada una, comprobar a qué se dedica de verdad y si pertenece a un grupo, y guardar capturas como evidencia. Una a una.
Así que construimos una herramienta que hace ese trabajo sola. Le das la empresa analizada y sus servicios, y va entrando en la web de cada candidata y aplicando los filtros cualitativos uno detrás de otro. Por ejemplo, si la web funciona, a qué se dedica la empresa, qué tipo de servicio presta o si forma parte de un grupo multinacional. Con eso decide si la acepta o la rechaza, y cada decisión va acompañada de su justificación y de sus capturas, para que cualquiera pueda revisar por qué se ha tomado.
Por otro lado, la última palabra la tiene siempre el analista. Puede cambiar cualquier decisión y explicar por qué, y la IA sigue trabajando a partir de ahí. Al final te llevas el Excel con el formato de Grant Thornton y un comprimido con todas las evidencias.
Con esto analizamos 91 empresas en unos minutos y nos llevamos el premio del reto. Y lo mejor es que el analista puede dedicar su tiempo a lo que importa, que es analizar, y no a abrir pestañas una detrás de otra.
- 1.º premio del reto de Grant Thornton
- 91 empresas analizadas en unos minutos
- 4 filtros, cada uno con su justificación
Ir a nodicus.com
R-HDBSCAN
Durante mi estancia en la Diputació de València trabajamos con los datos de unos sensores que detectan cuánta gente pasa por distintas zonas de València y de la Comunitat Valenciana, y a partir de ahí pudimos calcular cuánta gente se desplaza de un municipio a otro.
Para los que no estéis familiarizados con el tema, la idea es ver la Comunitat como un grafo, en el que cada municipio es un punto y cada par de municipios está unido por un arco. Y el objetivo era que el peso de cada arco reflejara de verdad cuánta gente va de uno a otro, de forma que cuadrara con lo que detectan los sensores.
Lo primero fue ordenar los datos. Los partimos en ventanas de 10 minutos y, para cada par de municipios, calculamos los desplazamientos a 20 y 40 minutos, a una hora, a un día y a una semana. Además, a cada uno le añadimos todo lo que podía ayudar a explicarlo, como la distancia física, a pie y en coche, las detecciones en origen y en destino, la fecha y la hora, si era festivo o no y las coordenadas de los dos municipios.
Y aquí es donde entra R-HDBSCAN. HDBSCAN es un algoritmo que agrupa los datos que se parecen sin que tengas que decirle cuántos grupos quieres (muy útil cuando no tienes ni idea de cuántos hay). El problema es que, con tantos datos y tan distintos, es fácil que te devuelva grupos demasiado grandes como para sacar algo en claro. Así que lo hicimos recursivo. Entrenas HDBSCAN, ajustas los parámetros y lo vuelves a aplicar sobre los grupos que han salido, y así hasta quedarte con grupos pequeños que tengan las características que buscas. De hecho, entrenamos uno para cada horizonte de tiempo, de los 20 minutos a la semana.
Por otro lado, una vez tienes los grupos hechos, cualquier dato nuevo que llega se puede asignar al grupo que le corresponde.
Codificación de garantías con IA
Este es uno de los proyectos que hemos hecho en nódicus, para un taller de camiones. Para cobrar una reparación en garantía, al fabricante del camión no le basta con que le expliques qué has hecho. Quiere cada trabajo clasificado en un árbol de más de 12.000 códigos por camión, y si te equivocas, la garantía no se cobra.
Buscar esos códigos a mano lleva un buen rato y, con tantas opciones, es facilísimo equivocarse. Por eso construimos un asistente que lee el aviso del taller y propone los códigos que encajan, cada uno con su nivel de confianza.
La primera versión intentaba hacer lo mismo que haría una persona. Era un agente en LangGraph que se metía en el árbol, abría y cerraba carpetas, buscaba por significado y por palabras clave y se quedaba con los códigos que encajaban. Incluso redactaba el procedimiento de trabajo para el mecánico.
Pero luego le dimos la vuelta. Casi todo lo que se hace en un taller ya se ha hecho antes, así que la versión final empieza buscando precedentes en lo que el propio taller ya validó. Después pone a tres modelos de lenguaje a leer el aviso por separado y solo se queda con los códigos en los que coinciden. De hecho, si un código no tiene detrás un precedente o el acuerdo de los modelos, se descarta, porque es mucho más útil proponer ocho códigos buenos que veinte entre los que tengas que elegir.
Además, el revisor ya no parte de cero. Confirma, quita lo que sobra y añade lo que falte, y la última palabra sigue siendo suya. Y cada aviso que valida pasa al histórico, así que el sistema mejora con el uso sin tener que reentrenar nada.
En cuanto a los números, encuentra el 72 % de los códigos correctos (el objetivo era el 65 %), acierta todos los que propone con una confianza del 90 % o más y tarda entre 40 y 80 segundos por aviso, cuando el objetivo eran dos minutos. Todo por menos de 10 céntimos por aviso. Y ya está en producción.
- 72 % de los códigos correctos (objetivo: 65 %)
- 40-80 s por aviso (objetivo: 2 min)
- < 0,10 € por aviso
Ir a nodicus.com
Informes de visitas comerciales con IA
Otro de los proyectos de nódicus fue para un distribuidor con su propio equipo de comerciales. Un comercial solo vende cuando está delante de un cliente, pero aquí cada semana de visitas iba seguida de otra en la oficina, escribiendo los informes, pasándolo todo a la base de datos y preparando las visitas siguientes.
Y ese trabajo hace falta, porque si no nadie sabe qué se habló con cada cliente ni qué quedó pendiente. El problema es que no vende, así que cuando se acumula, los informes se hacen tarde, cortos o directamente no se hacen.
Lo resolvimos con algo tan sencillo como un audio. Al salir del cliente, el comercial graba lo que ha pasado, como se lo contaría a un compañero. Un modelo de voz a texto lo transcribe y un flujo en LangGraph lo convierte en un informe estructurado, que se guarda junto a la ficha del cliente. Además, de ahí salen solas las tareas para el resto del equipo, como enviar una promoción, programar otra visita o preparar un presupuesto.
Por otro lado, antes de cada visita hay un botón dentro del CRM que ya usaban que genera un resumen de dos páginas. Ahí tienes con quién vas a hablar, lo más importante de las últimas visitas, qué compra y si está comprando más o menos que antes, así que el comercial llega a la reunión sabiendo a quién tiene delante.
Con esto se ahorran unas 30 horas de trabajo manual al mes y todas las visitas quedan documentadas. Y es que grabar dos minutos de audio al salir del cliente cuesta mucho menos que sentarse a escribir el informe a final de semana.
- 30 h de trabajo manual ahorradas al mes
- 100 % de las visitas documentadas
Ir a nodicus.com
Visión por computador en farmacia hospitalaria
Uno de los proyectos en los que estamos trabajando ahora en nódicus es de visión por computador, para supervisar procesos en la farmacia de un hospital.
Para los que no estéis familiarizados, la visión por computador es la rama de la IA que se encarga de que un ordenador entienda lo que ve en una imagen o en un vídeo. Y en este caso la usamos como un par de ojos más que no se cansan nunca.
Eso sí, la idea no es sustituir a nadie. Es una capa más de seguridad, y la última palabra la sigue teniendo la persona (que en nódicus es una regla para todos los proyectos).
Por ahora no os puedo contar mucho más, porque el proyecto sigue en marcha y en un hospital la confidencialidad va muy en serio. Cuando se pueda, os lo cuento con todo detalle.
Ir a nodicus.com
Proyectos académicos
Un agente de IA científico de datos
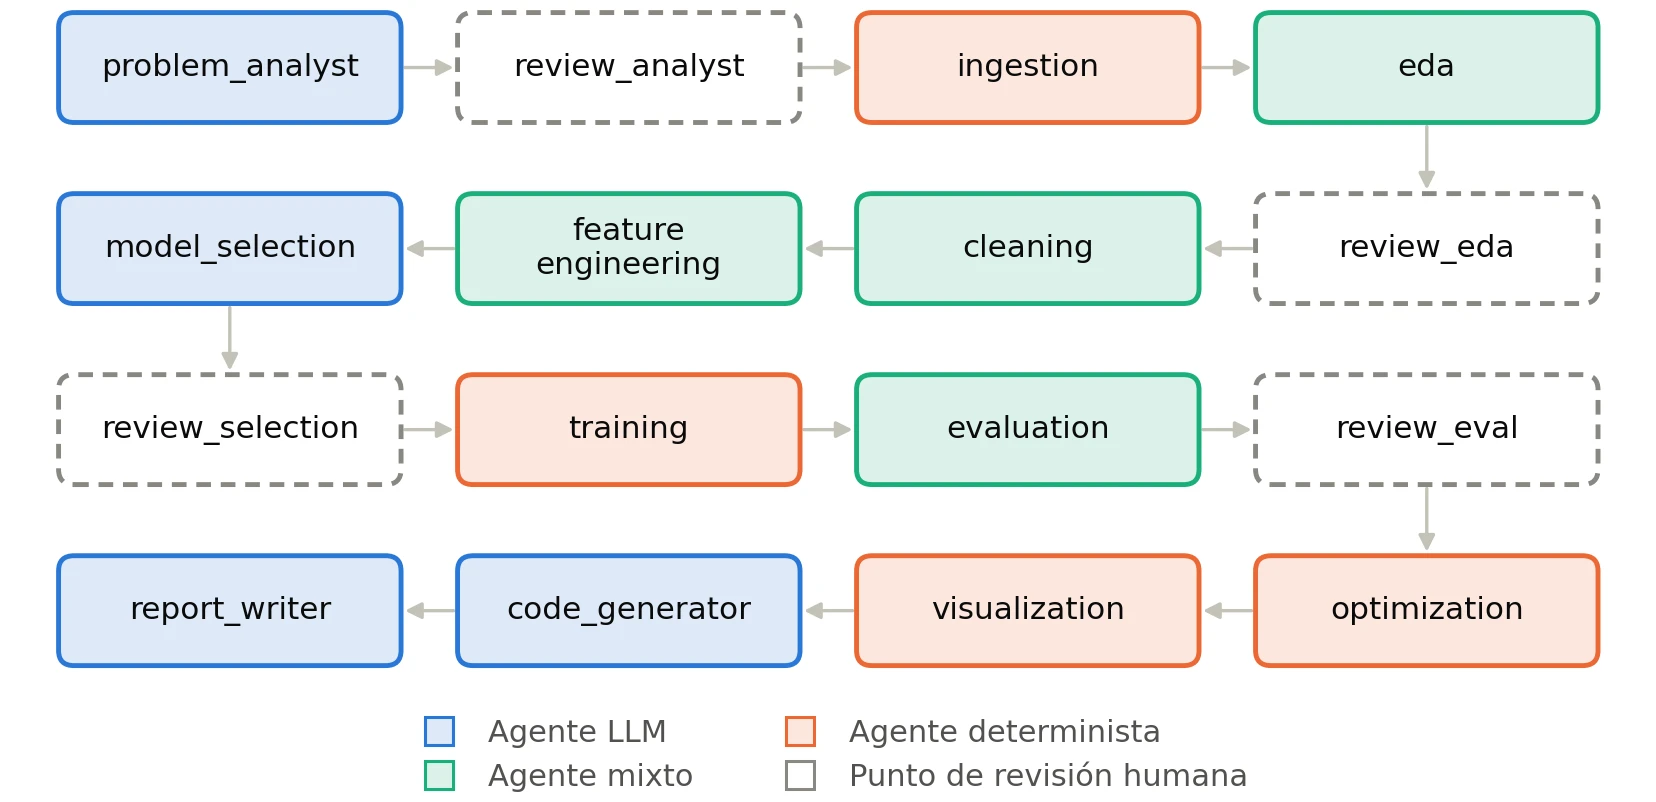
Mi TFM del máster de IA de la UPV consistió en crear toda la estructura y flujo de un agente abierto y trazable que hiciese las veces de científico de datos (a ver si me quito mi propio trabajo). La idea es que, a partir de tus datos y tu objetivo, haga todo el trabajo de un proyecto de ciencia de datos de principio a fin.
Y aunque pueda parecer que esto es AutoML 2.0, realmente no, ya que el AutoML se dedica a optimizar la elección del modelo y sus parámetros. Pero el trabajo de un científico de datos va mucho más allá. Limpiar datos, entender lo que se busca (explicado en lenguaje natural), juntar fuentes que no se parecen en nada y, al final, explicar los resultados a quien los tiene que usar. Y para todo eso un modelo de lenguaje viene muy bien.
Así que lo monté con LangGraph. Un flujo de doce nodos/agentes que cubren todas las fases de vida de un proyecto de ciencia de datos, un agente crítico que revisa el trabajo de los demás y cuatro puntos de control en los que una persona revisa y decide antes de seguir. Todo con el modelo en local, para que tus datos no salgan de tu máquina. Eso sí, el modelo de lenguaje no hace ninguna cuenta. Decide qué hay que calcular y escribe el código, pero las métricas, las particiones y el entrenamiento salen de ejecutar ese código. Si le dejas a un LLM que te calcule una media, lo mismo te la inventa.
Luego tocaba medirlo, que fue lo que más trabajo me dio. Hice 72 ejecuciones para comparar tres versiones del sistema, y me llevé un par de sorpresas. La primera, que el agente crítico gastaba un 47 % más de tokens y no mejoraba la nota, así que no compensaba. La segunda, que el punto débil de verdad estaba en otro sitio, porque de los 72 scripts que generaba, 43 ni se ejecutaban. Le añadí un bucle que le devuelve el error al modelo para que lo arregle, y pasaron a funcionar 69.
Además, mi propia rúbrica no servía para distinguir entre sistemas (siete de los diez criterios daban siempre un 1), así que monté un banco de evaluación propio, DS-AUDIT, para compararlo con otros agentes. Contra AIDE, el mío pierde en rendimiento, pero gana en reproducibilidad (total) y en fugas de datos (ninguna).
Y al final, para trabajar con datos de verdad, prefiero un agente del que me pueda fiar a uno que acierte un poco más.
- 29 → 69 de 72 scripts que se ejecutan
- 12 + 1 agentes y un crítico
- 1,00 de reproducibilidad (AIDE: 0,27)
Leer el TFM
Fibrosis auricular con IA
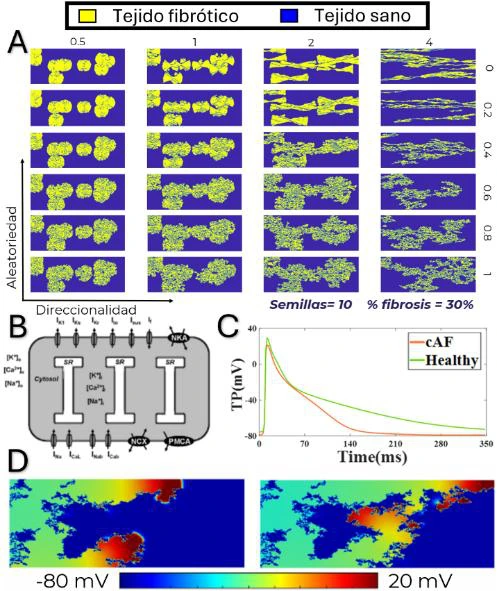
Mi trabajo de fin de grado lo hice en el CoMMLab, un grupo de investigación de la Universitat de València que simula la actividad eléctrica del corazón, y es de los proyectos en los que más trabajo he metido. Todo partía de una pregunta. ¿Se puede saber cuánta fibrosis tiene una aurícula solo con mirar la forma de su señal eléctrica?
Para los que no estéis familiarizados, la fibrilación auricular es una arritmia en la que las células de la aurícula se activan de forma rápida e irregular, y uno de los motivos que la provocan es la fibrosis, un exceso de colágeno en el músculo auricular que altera cómo se conduce la electricidad. Hoy en día la fibrosis se mide con resonancias con contraste o con mapas de voltaje, que son métodos complejos, necesitan equipos especializados y su eficacia está en duda.
Mi hipótesis era que la forma de la señal (el electrograma) guarda información sobre el tejido más allá de su amplitud, que es lo único que se mira en los mapas de voltaje. El problema es que con pacientes reales nunca sabes exactamente cuánta fibrosis hay, así que había que simularlo.
Por eso simulé 225 tejidos auriculares distintos, con entre un 5 % y un 25 % de fibrosis repartida de formas diferentes, y cómo se propaga la electricidad por cada uno. Sobre ellos coloqué 132 electrodos virtuales y saqué más de 200.000 muestras de electrogramas unipolares, bipolares y omnipolares, que son los tipos que se usan en la clínica.
Con todo eso entrené redes convolucionales que, a partir de un fragmento de señal, deciden en cuál de los cinco niveles de fibrosis está el tejido. Mirando cada señal por separado, el mejor modelo (el de las señales unipolares) acertaba el 71 % de las veces. Pero todas las señales de una misma simulación tienen la misma fibrosis, así que si juntas sus predicciones y te quedas con la más votada, el acierto sube al 91 %.
Eso sí, en un hospital nunca vas a tener todas las señales de una aurícula, así que probé formas de agrupar más realistas. Con solo 25 señales al azar, el acierto se queda en torno al 89 %. Y cogiendo un electrodo y sus 35 vecinos, que se parece más a lo que mide un catéter, ronda el 87 %.
Lo publiqué como primer autor y lo presenté en el congreso CASEIB 2025, en Zaragoza. Está hecho con datos simulados y no con pacientes, así que es solo un primer paso y habría que validarlo con datos clínicos reales. Pero si funcionara, se podría llevar a los dispositivos que se usan durante una ablación para estimar la fibrosis en el momento y ayudar al personal sanitario durante el tratamiento.
- 71 → 91 % de acierto: por señal y agrupando
- 200.000+ electrogramas
- CASEIB 2025 primer autor y ponente
Leer el artículo
Proyectos personales
Programas 29N
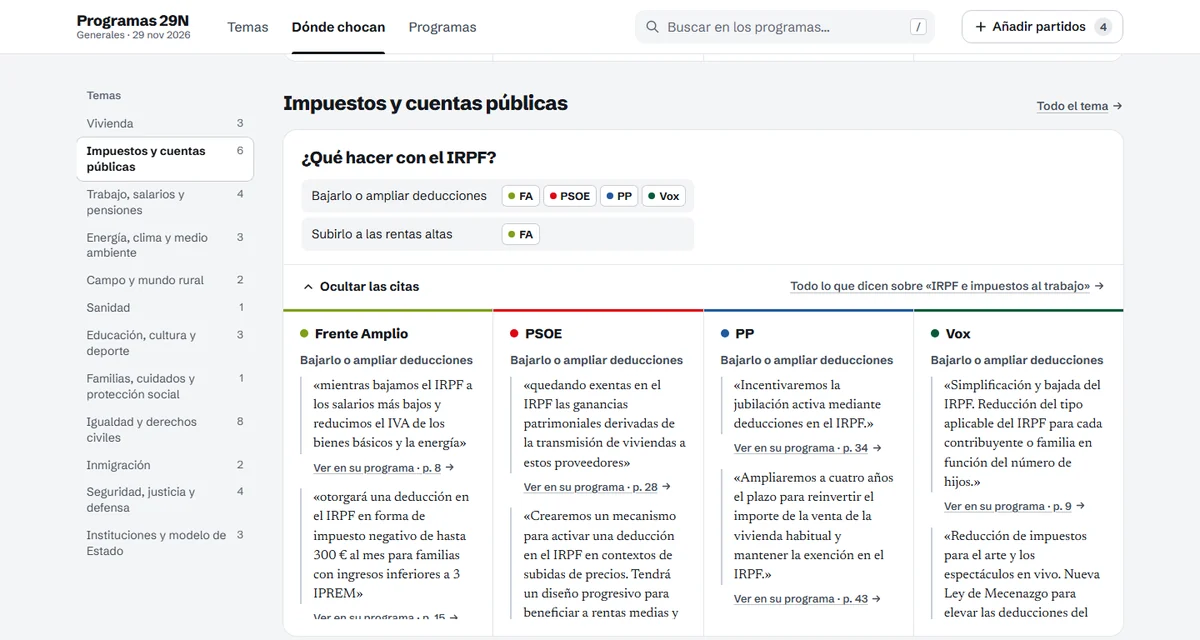
Antes de votar me gusta saber qué propone cada partido. Pero no escuchando lo que suelta un candidato en un debate o en un corte de veinte segundos, sino atendiendo a lo que pone en su programa electoral. El problema es que casi nadie se los lee, y es normal, porque solo los de los cuatro partidos grandes suman casi 400 páginas.
Así que, para las generales del 29 de noviembre de 2026, monté una web que los ordena por temas. Son 17 bloques y 111 subtemas, y en cada uno tienes lo que dice cada partido, uno al lado del otro. Además, hay 40 preguntas en las que los partidos no se ponen de acuerdo, como qué hacer con el IRPF o si hay que limitar el precio del alquiler, con la postura de cada uno y la cita de su programa que la respalda.
Lo primero fue pasar los PDF a texto, que es menos fácil de lo que parece. Cada partido maqueta su programa a su manera (los hay de 15 páginas y de más de 150), así que muchos necesitaron su propia limpieza. Después los partí en extractos, cada uno con la página del PDF del que sale. Y después un script comprueba que no se ha perdido ni una línea por el camino.
Por otro lado, los titulares, la clasificación por temas y las posturas de cada pregunta los hizo un modelo de IA (Claude). Pero aquí no basta con que acierte casi siempre, porque estamos hablando de lo que defiende cada partido. Así que todo pasa por scripts de validación. Cada extracto tiene que acabar en algún subtema y cada cita tiene que aparecer palabra por palabra en el programa. Eso sí, el texto de los partidos no lo toca nadie, ni la IA ni yo. No se resume ni se corrige, y en la web se distingue a simple vista lo que es suyo de lo que he puesto yo.
Y como en unas elecciones la neutralidad lo es todo, todos los partidos tienen el mismo tamaño y el mismo peso visual. La web no te dice a quién votar. Te enseña qué ha prometido cada uno, para que decidas tú.
Porque un programa electoral es (o debería ser) lo que el partido hará si le votas. Y para exigir que lo cumplan, primero hay que leerlo.
- 12 programas electorales
- 4.215 extractos, todos literales
- 40 preguntas en las que chocan
Ir a la web · Ver el código
Tesla Runner
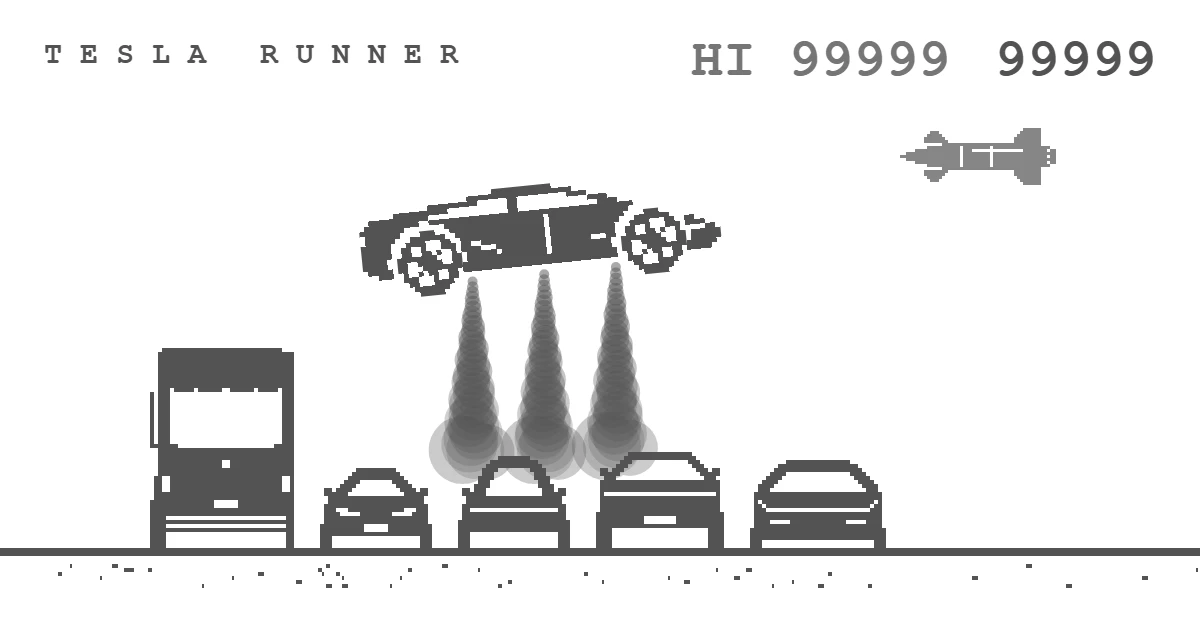
¿Qué pasa si al dinosaurio de Chrome le das un Tesla Roadster (a.k.a. el coche que vuela)? Pues que en vez de saltar cactus, saltas camiones y Starships.
Todo empezó en octubre, cuando acababa de salir el nuevo Roadster volador. Vi en Twitter una imagen trucada del juego del dinosaurio, pero con un Tesla, y me hizo tanta gracia que me dije que tenía que hacerlo. En un día lo tenía hecho, todo en un solo archivo HTML y sin ninguna dependencia.
Para que se sintiera igual que el original, saqué la física del código fuente del T-Rex de Chrome (la gravedad, las velocidades, los huecos entre obstáculos). Y luego le añadí todo lo que le faltaba. Por ejemplo, si mantienes el salto tiras de propulsores, hay rampas gigantes que te ponen boca abajo y los flips y los barrel rolls suman puntos (eso sí, si aterrizas mal, explotas). Además tiene controles táctiles para jugar en el móvil y un TOP 100 con las mejores puntuaciones.
Os reto a entrar en el TOP 100. ¿Cuántos puntos hacéis?
- 1 día para hacerlo
- 1 archivo HTML
- 0 dependencias
Jugar · Ver el código
Gaviota 3D
En la asignatura de Gráficos por Computador del máster de IA de la UPV teníamos que hacer un proyecto en three.js, y el mío se llama «¡ME CAGO EN TODO!». El título lo resume bastante bien, porque eres una gaviota que sobrevuela una ciudad y tu objetivo es cagarte en todo el que pase por debajo.
Pero detrás de la broma hay bastante trabajo. La ciudad tiene cientos de edificios con sombras, pintados con instancing (dibujando de una sola vez muchas copias del mismo objeto) para que no se arrastre. Hay siete pájaros a elegir, cada uno con su velocidad y su munición, desde el colibrí hasta Charizard. Los peatones están animados, entran en pánico y gritan con sonido posicional, así que los oyes desde donde están. Y además tiene un minimapa y una vista de águila.
Lo mejor es que los peatones son mis compañeros de clase, con su nombre y todo. Cuando aciertas a uno, te sale una notificación (para que te regodees). Y si te comes un kebab, tienes diez segundos de… digamos que de munición extra.
En esa asignatura saqué matrícula de honor. Se juega en el navegador, así que podéis probarlo vosotros mismos (ojo con el kebab).
Jugar · Ver el código
Este cuarto
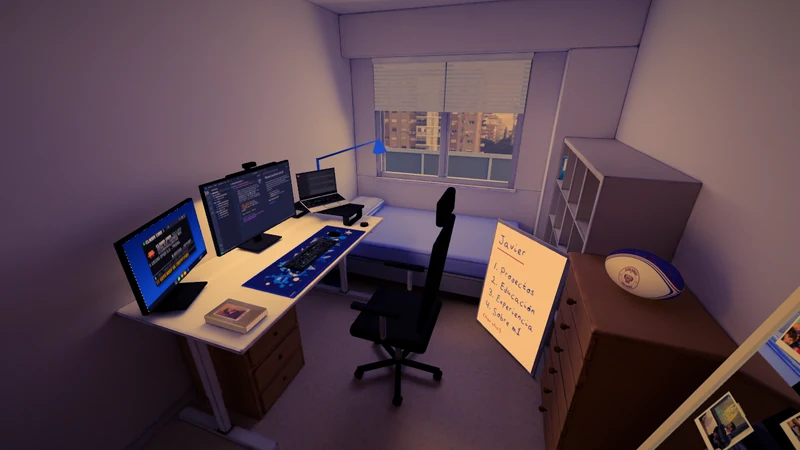
Los portfolios suelen ser todos iguales: una foto, cuatro proyectos en tarjetitas y un botón de contacto. Y oye, funcionan. Pero a mí me apetecía otra cosa.
Y pensando, pensando, me di cuenta de que mi habitación es una de las cosas que mejor me representan. Donde he pasado gran parte de mi vida. Así que qué mejor forma de presentarme que invitaros a mi cuarto.
Y como soy una persona que lleva el ojo por el detalle al límite, quise crear mi cuarto de verdad. Con sus medidas reales, todos mis muebles y mi setup. Nada está modelado a mano, el cuarto entero sale de un script de Python para Blender que construye cada mueble por código, y la luz la calcula Cycles y se queda horneada en texturas de día, atardecer y noche. Pero eso es solo la base, porque después vino lo divertido.
Para presentarme, tanto a nivel personal como profesional, diseñé varios apartados: proyectos, experiencia, formación y sobre mí; y relacioné cada apartado con un elemento de mi habitación (el monitor, la ventana, el libro de la mesa y el espejo), para que al pulsarlo te contase esa parte de mí. Cada apartado está creado de forma personalizada, intentando que encaje a la perfección con su elemento y con lo que busca transmitir.
Pero como esto es algo que hago por puro placer, decidí que la cosa no acababa ahí. Aunque no tuviesen ninguna funcionalidad útil, decidí meter otro tipo de interacciones: easter-eggs (como el del balón de rugby), interacciones con el cuarto (como las persianas) e interacciones con el mundo real (como el tiempo que hace en la ventana, que es el de Valencia en ese momento, o el sol, que entra según la hora real). Todo eso lo mueve three.js en el navegador, y la escena solo se vuelve a pintar cuando algo cambia, para que vaya fluido en cualquier ordenador y también en el móvil.
La idea de este proyecto es hacer una página personal que me represente más allá de mi información académica y profesional. Un lugar en el que me puedas conocer a mí como persona, que esté vivo y pueda ir evolucionando. Y sobre todo, el objetivo era hacer algo que me gustase a mí.
- 1:1 medidas reales del cuarto
- 0 objetos modelados a mano
Ver el código
Experiencia
Cofundador e ingeniero de IA · nódicus
Desde oct 2025
En octubre de 2025 fundé nódicus junto a Pedro de Luna, otro científico de datos de Valencia. Nos dedicamos a desarrollar soluciones de inteligencia artificial a medida para empresas, ya sea con machine learning, deep learning, visión por computador o agentes con modelos de lenguaje.
Al ser solo dos, toco todas las fases de cada proyecto. Desde la primera reunión con el cliente, en la que intentamos entender su negocio y sus datos, hasta la propuesta, el desarrollo, la puesta en producción y el soporte posterior (así que un día estoy programando y al siguiente preparando una propuesta).
Y lo que más me gusta es que cada proyecto empieza por entender un negocio que no es el nuestro. Por ejemplo, hemos trabajado para un taller de camiones que tenía que codificar sus garantías, para un distribuidor cuyos comerciales pasaban una semana de cada dos en la oficina escribiendo informes y para la farmacia de un hospital. Son mundos que no tienen nada que ver entre sí, y en cada uno hay que traducir sus problemas a un problema de IA que se pueda resolver. De hecho, esa parte suele ser más difícil que la técnica.
Además, trabajamos con dos principios inamovibles. El primero, que todo resultado se pueda rastrear hasta el dato del que sale, para que nadie tenga que fiarse de una caja negra. El segundo, que la última palabra la tenga siempre la persona que usa la herramienta, porque la IA propone, pero quien conoce el negocio es ella.
Por otro lado, emprender te obliga a aprender cosas que en la carrera ni se mencionan, como preparar una propuesta, ponerle precio a un proyecto o explicarle a alguien que no es técnico por qué le conviene meter IA en su empresa (o por qué no). Y si tenéis un problema que creéis que se puede resolver con IA, ya sabéis dónde encontrarnos.
Investigador en deep learning · CoMMLab, Universitat de València
Ene – jun 2025
Con motivo de mi trabajo de fin de grado, de enero a junio de 2025 formé parte del CoMMLab, un grupo de investigación de la Universitat de València que se dedica a simular la actividad eléctrica del corazón.
Me dirigió Miguel Rodrigo, y cada semana nos reuníamos todo el grupo. Cada uno presentaba sus avances y los discutíamos entre todos, así que no había forma de esconder un resultado flojo (ni tampoco ganas).
En mi caso, el trabajo consistía en averiguar si se puede estimar cuánta fibrosis tiene una aurícula solo a partir de la forma de su señal eléctrica. Para ello simulé 225 tejidos auriculares, saqué más de 200.000 electrogramas y entrené redes convolucionales que llegaron a acertar el 91 % al juntar las predicciones de cada simulación (en el apartado de proyectos os lo cuento con más detalle).
Allí aprendí muchísimo, tanto de mi propio trabajo como del de mis compañeros. Por ejemplo, aprendí que en investigación cada resultado tienes que poder defenderlo delante de gente que sabe más que tú, y que un «creo que funciona» no vale si no lo puedes demostrar. Además, me tocó meterme de lleno en un campo que no era el mío, la electrofisiología cardiaca, y entender lo suficiente de medicina como para que lo que hacía tuviera sentido.
Al final, el trabajo terminó en un artículo que presenté como primer autor en el CASEIB 2025, el congreso anual de la Sociedad Española de Ingeniería Biomédica, en Zaragoza. Y la verdad es que disfruté mucho presentándolo (algo tendrá que ver el teatro).
Científico de datos (prácticas) · Diputació de València
Oct – dic 2024
Las prácticas del grado las hice en la Diputació de València, como científico de datos, de octubre a diciembre de 2024. Fue la primera vez que trabajé como científico de datos fuera de la universidad, y además en un equipo de tres personas.
Trabajamos con los datos de unos sensores que detectan cuánta gente pasa por distintas zonas de València y de la Comunitat Valenciana. La idea era entender cómo se mueve la gente de un municipio a otro y qué zonas se comportan de forma parecida, algo que a una institución pública le viene muy bien saber.
Para ello partimos los datos en ventanas de 10 minutos, calculamos los desplazamientos entre cada par de municipios a distintos plazos (de 20 minutos a una semana) y les añadimos todo lo que podía ayudar a explicarlos, como las distancias, la hora del día o si era festivo.
Y para agruparlos diseñamos R-HDBSCAN, una variante recursiva del algoritmo de agrupamiento HDBSCAN. Para los que no lo conozcáis, HDBSCAN junta los datos que se parecen sin que tengas que decirle cuántos grupos quieres, pero con tantos datos es fácil que te devuelva grupos demasiado grandes. Así que lo aplicamos una y otra vez sobre los grupos que salían, hasta quedarnos con grupos pequeños y con sentido (en el apartado de proyectos tenéis todo el detalle).
Además, al ser tres, nos repartíamos el trabajo y lo poníamos en común, así que aprendí a coordinarme con otras personas en un proyecto de datos de verdad, con sus plazos y sus imprevistos.
Desarrollador de software · Pksiam
Sep 2022 – jul 2023
Mi primer trabajo como programador fue en Pksiam, una empresa que desarrolla soluciones web a medida para farmacia hospitalaria. Estuve de septiembre de 2022 a julio de 2023, compaginándolo con el segundo curso del grado (lo que se tradujo en bastantes menos horas de sueño).
En general la farmacia de un hospital no se parece en nada a la farmacia de tu barrio. Se encarga de preparar y controlar la medicación de los pacientes ingresados, y para eso necesita programas hechos a su medida.
Allí trabajé tanto en el frontend, con HTML, CSS y JavaScript, como en el backend, con C# y SQL. Es decir, desde lo que ve el usuario en la pantalla hasta las consultas a la base de datos que hay detrás.
Fue mi primer contacto con el desarrollo de software en un entorno profesional. Por ejemplo, aprendí que el código no solo tiene que funcionar, sino que también lo tiene que entender el siguiente que lo toque, y que cuando una aplicación se usa cada día en un hospital, los errores no se pueden dejar para mañana.
Más sobre mí
Rugby
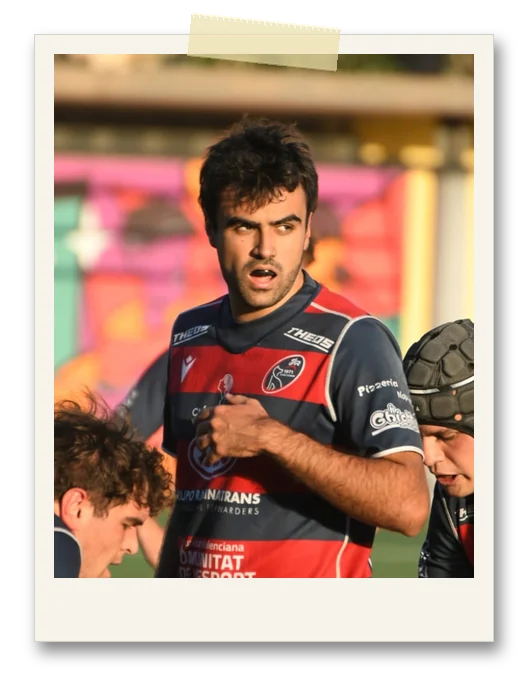
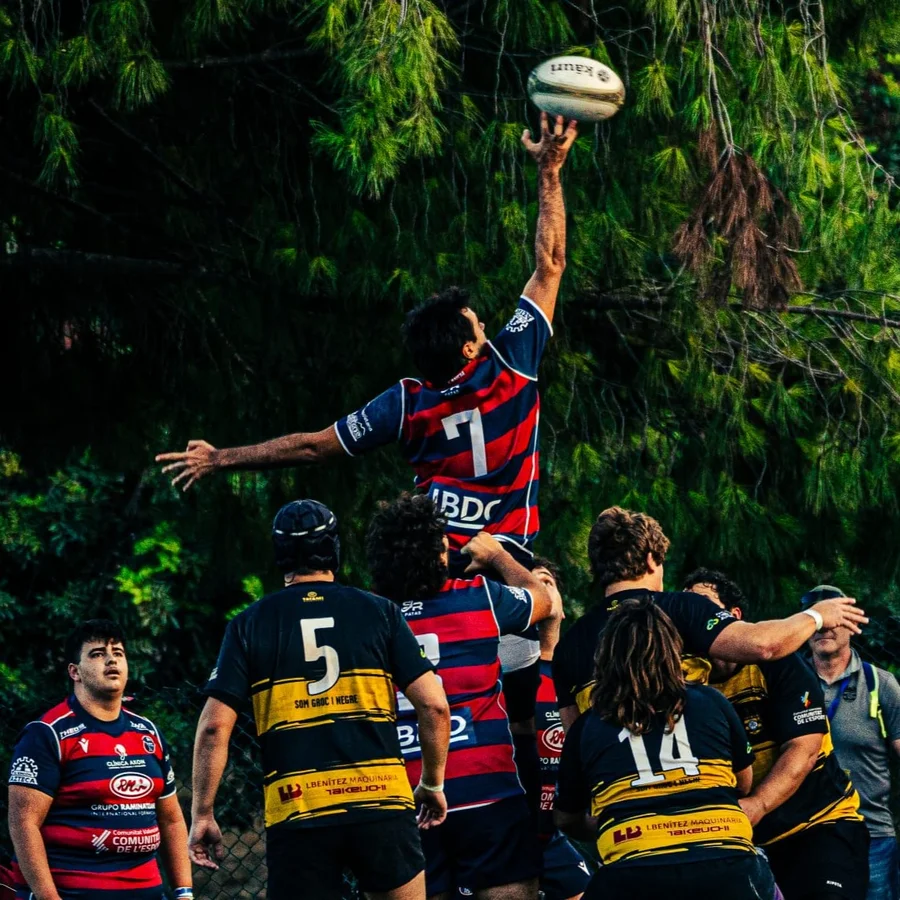
Una de mis pasiones es el rugby. Empecé a jugar en 3º de la ESO (en 2017) y desde entonces no he parado. Juego en el Club de Rugby San Roque, en la posición de flanker (6/7).
Respeto
Una de las cosas que más me ha inculcado el rugby es el respeto: el respeto por el árbitro, el entrenador, mis compañeros y mis rivales. Por ejemplo, en el rugby los jugadores no pueden hablar con el árbitro, solo el capitán, y debe hacerlo con mucha educación porque gritar o insultar al árbitro es tarjeta directa.
Equipo
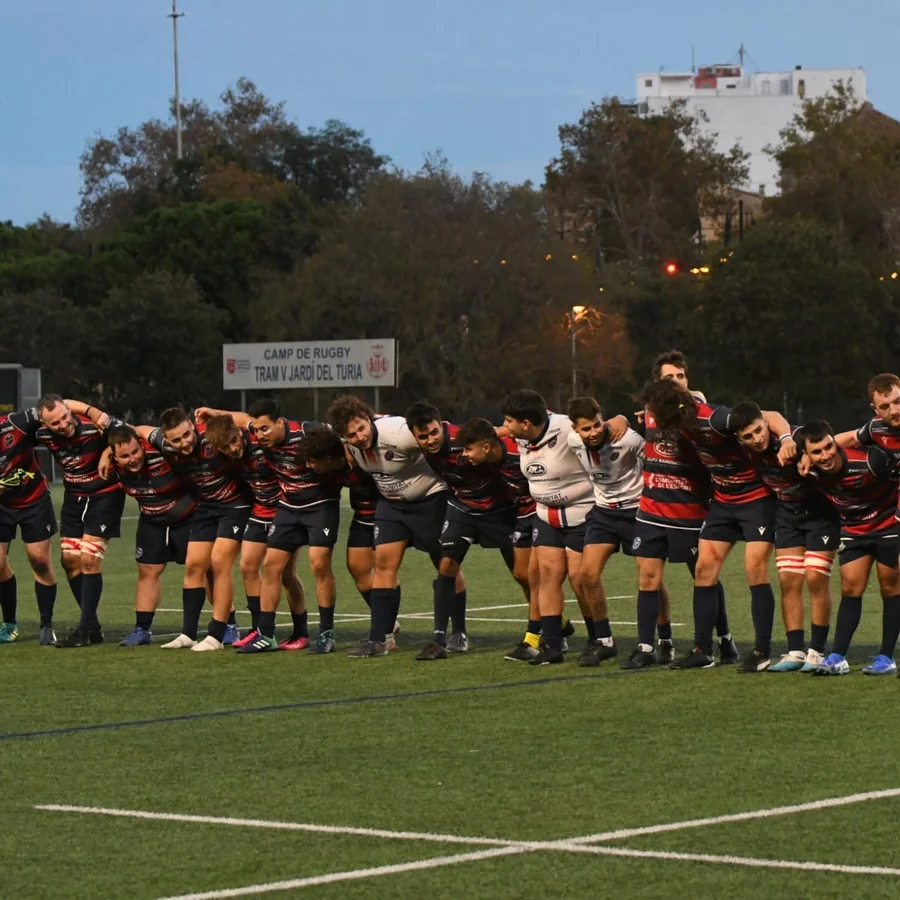
Por otro lado, algo que considero fundamental del rugby es que es un deporte de equipo por excelencia. En el campo, los egos se dejan atrás y pasamos a ser una unidad. De hecho, es de los pocos deportes en los que no hay nombres ni dorsales personales. Los 15 jugadores iniciales llevan los dorsales del 1 al 15 en función de la posición que ocupan. No hay estrellas, solo piezas de un engranaje común.
Además, el rugby es un deporte para cualquier persona. Da igual que seas alto o bajo, gordo o flaco, rápido y ágil o fuerte y decidido. Siempre habrá un rol para ti. Los delanteros (o «gordos», apodo cariñoso para los jugadores del 1 al 8) son la potencia del equipo. Placan y chocan contra los delanteros del otro equipo y generan espacios. Y luego están los 3/4 (jugadores del 9 al 15), que corren aprovechando esos espacios para superar la línea defensiva y ensayar un tanto.
Sevens Universitario
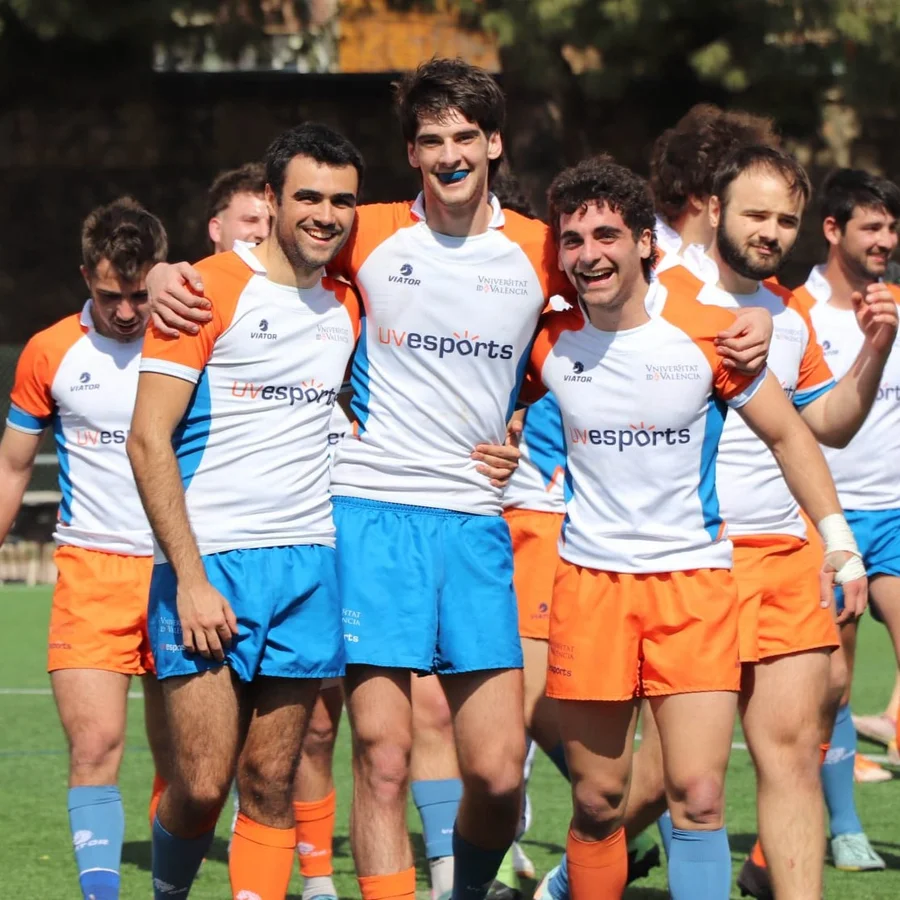
El rugby también me ha acompañado en la universidad. Estuve dos años en la selección de rugby 7 de la Universitat de València y los dos años ganamos el campeonato universitario de la Comunitat Valenciana (el CADU), dos oros. En ambos años fuimos al Campeonato de España Universitario (CEU), y el primer año quedamos terceros, con el bronce. Y cuando me fui de Erasmus a Roma también jugué con el equipo de 7 de La Sapienza, con el que fuimos a un torneo, el WIUC.
Hackathones
De entre mis muchos hobbies, uno que me encanta es asistir a hackathones.
¿Qué son?
Para los que no los conozcáis, los hackathones son eventos en los que, por equipos, se intenta resolver un problema en unas horas y se expone la solución a un jurado al final del evento.
Lo que más me gusta
Lo que más me gusta de los hackathones es que conoces a mucha gente maja y buena. Me he encontrado con gente muy ambiciosa, con ganas de hacer y de experimentar, y eso a mí me da la vida. Además, me encanta enfrentarme a retos nuevos y desconocidos, pensar y retarme a mí mismo a la innovación cognitiva.
Lo profesional
En cuanto a lo profesional, está muy bien porque haces networking y conoces a muchas empresas que plantean problemáticas que tienen, lo que te permite ver mucho más allá de lo que conoces y entender qué es lo que pasa en otros sectores o nichos.
Mi papel en el equipo
Se me da muy bien liderar equipos, y también adaptarme y cumplir el rol que el equipo necesita de mí, ya sea llevar las riendas, delegar o impulsar las ideas de mis compañeros. Además soy muy buen orador, y suelo hacer los pitchs finales. Por mi experiencia en teatro, disfruto mucho hablando ante un público y buscando transmitir todo lo que hemos desarrollado en equipo durante las horas del hackathon.
Mis hackathones
Viajar
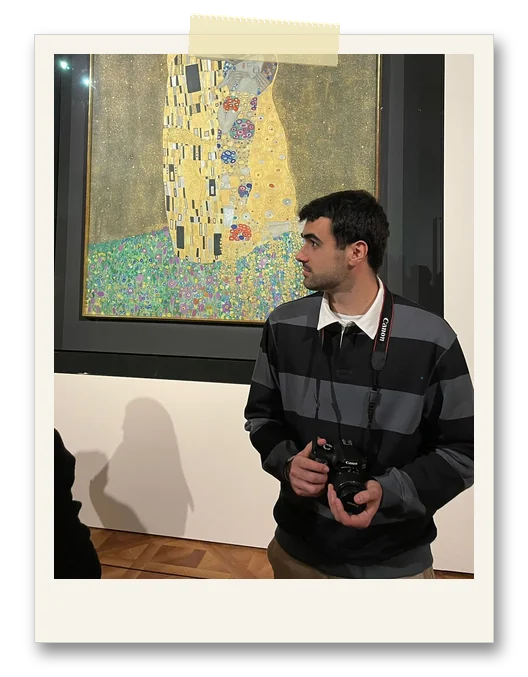
Me encanta viajar. Conocer otras culturas, otros lugares y otras gastronomías me ha impulsado a moverme y lanzarme a ver mundo. Hasta ahora he visitado 19 países ... ¡y los que me quedan!
Países que he visitado (19):
- Canadá
- Noruega
- Francia
- Tailandia
- Austria
- Hungría
- Alemania
- Croacia
- Luxemburgo
- Portugal
- España
- Irlanda
- Italia
- Reino Unido (Inglaterra)
- Eslovaquia
- Chequia
- Marruecos
- Andorra
- Ciudad del Vaticano
Historia
Cuando visito una ciudad, un monumento o un museo, lo que más me gusta es que me cuenten la historia que hay detrás. Ya no los datos informativos, sino la narrativa que los envuelve. Entre free tours, audioguías y lo que dice Wikipedia, me atiborro de información hasta que me sale por las orejas.
Naturaleza
Pero no solo me gusta viajar a la ciudad. Otra cosa que me encanta es conocer la naturaleza de las zonas a las que viajo. Ya sea playa o montaña, ver paisajes tan distintos a los que acostumbro en España me llena de un asombro y una paz inmensas. Y cuando viajo intento informarme sobre las riquezas naturales del país para hacer alguna ruta o excursión y poder disfrutarlas.
Gastronomía
Y por supuesto, como español de buen comer, una de las cosas que más me gusta de viajar es probar otras gastronomías. Intento probar siempre el core de la gastronomía del país que visito, tocando todos los niveles, desde la comida callejera hasta sus mejores platos de restaurante (aunque intentando que no me sablen, que no soy de oro).
PD: La foto de esta sección es en el museo Belvedere de Viena, junto con el cuadro de «El beso» de Gustav Klimt, cuya copia ha estado toda mi vida encima del sofá de mi salón.
Libros que he leído
Leyendo ahora: Moby Dick, Herman Melville.
Ya leídos:
- Crónica del rey pasmado, Gonzalo Torrente Ballester